
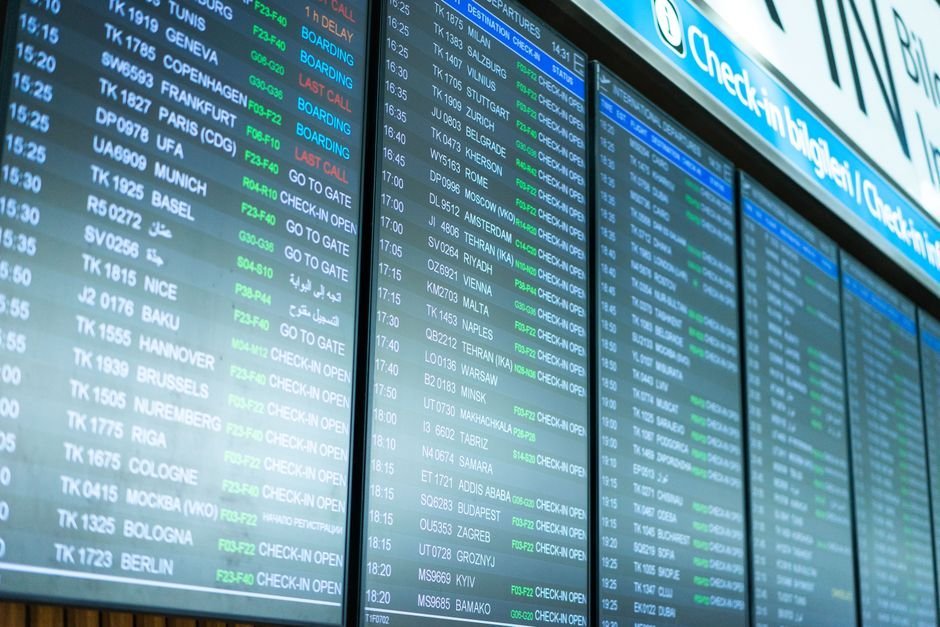
El pasado 8 de septiembre, los aeropuertos de Reino Unido vivieron uno de los episodios de mayor caos de los últimos años. Un fallo de software en el sistema nacional de control aéreo provocó la cancelación de cerca de 2,000 vuelos en cuestión de horas. Lo más impactante es que el origen del problema duró apenas un milisegundo, una fracción de tiempo prácticamente imperceptible para cualquier ser humano, pero suficiente para desatar una reacción en cadena que dejó a cientos de miles de pasajeros varados.
La empresa responsable de los servicios de navegación aérea en Reino Unido, NATS, reveló que todo comenzó cuando una solicitud relacionada con la identificación de una aeronave fue interrumpida por otra de mayor prioridad. Al intentar retomar el proceso, una falla muy específica del código provocó que los datos se alteraran. La ventana crítica duró alrededor de un milisegundo. De haber ocurrido antes o después, el sistema habría continuado operando con normalidad.
¿Qué pasó exactamente?
El problema afectó al National Airspace System, una plataforma fundamental para procesar información de los vuelos y permitir que los controladores identifiquen las aeronaves. Durante aproximadamente seis horas, el sistema presentó interrupciones y algunas funciones tuvieron que realizarse de manera manual. Para mantener los márgenes de seguridad, NATS redujo la cantidad de aviones que podían utilizar el espacio aéreo.
El resultado se sintió en los aeropuertos mucho después de que el sistema volviera a funcionar. Más de 2,000 vuelos fueron cancelados y cientos de miles de pasajeros quedaron afectados, con aeropuertos como Heathrow, Gatwick, Luton y Glasgow entre los principales puntos de la disrupción. El problema ya no era solamente el vuelo que no salía: había tripulaciones fuera de posición, aviones que debían ser recolocados y una red completa intentando recuperar su ritmo.
Un recordatorio de nuestra dependencia tecnológica
Más allá de la anécdota, este incidente deja una lección importante: la tecnología que hace posible que miles de personas atraviesen fronteras todos los días suele ser invisible hasta que deja de funcionar. Detrás de cada vuelo hay una infraestructura digital que coordina qué avión puede estar en qué lugar y en qué momento. Un pequeño error en el código puede tener consecuencias enormes.
NATS aseguró que la seguridad nunca estuvo comprometida y descartó que la interrupción hubiera sido provocada por un error humano o un ciberataque. Sin embargo, el episodio pone sobre la mesa la fragilidad de los sistemas complejos y la necesidad de contar con protocolos de respaldo robustos.
¿Qué pasa con los pasajeros afectados?
La Autoridad de Aviación Civil británica indicó que las cancelaciones y retrasos directamente derivados de esta falla probablemente entrarían en la categoría de “circunstancias extraordinarias”, por lo que no necesariamente generan una compensación económica. Las aerolíneas, sin embargo, siguen teniendo obligaciones de asistencia y deben ofrecer opciones como reembolso o reprogramación.
Para los viajeros, este tipo de situaciones resalta la importancia de contar con un seguro de viaje que cubra cancelaciones y retrasos, así como de mantenerse informados a través de los canales oficiales de las aerolíneas.
¿Qué podemos aprender de este incidente?
Más allá de Reino Unido, este caso nos recuerda que la aviación moderna depende de sistemas interconectados y que un fallo mínimo puede tener un efecto dominó. Para los paseros, la recomendación es siempre llegar con tiempo, tener planes alternativos y estar preparados para imprevistos. Para la industria, la lección es clara: la inversión en ciberseguridad y en sistemas redundantes es fundamental para evitar que un milisegundo se convierta en un dolor de cabeza de miles de millones de dólares.
Así que la próxima vez que abordes un vuelo, recuerda que detrás de esa aparente simplicidad hay una compleja red de software y hardware trabajando sin descanso. Y que, a veces, lo más pequeño puede desatar lo más grande.

Leave a Reply